録音中は、Apple の音声認識がこの Mac の中で文字起こしします。あとから、範囲・保存した録音・音声ファイルを、Whisper large-v3-turbo、Parakeet TDT (Japanese)、Cohere Transcribe (Beta) などの別のモデルで文字起こしし直せます。どのモデルもこの Mac の中で動き、音声はどこにも送りません。Apple 以外のモデルは、先に「設定 › モデル」でダウンロードします。
録音中の文字起こし
録音中(ライブ)の文字起こしには、いつも Apple の音声認識(SpeechAnalyzer)を使い、選んだ話す言語で文字起こしします(言語)。「設定 › 文字起こし」の「録音中に文字起こしする」がオンのあいだ動きます(既定はオン)。ほかのモデルは、文字起こしのやり直しにだけ使います。
発話の検出
音声認識は、電力を節約するため無音と判断した部分を飛ばします。そのとき小さな声も飛ばされることがあります。どこまで文字起こしするかは、「設定 › 文字起こし」の 2 つで決めます。
- ミーティング中は常に文字起こしする(既定はオン) — ミーティング中は、音量にかかわらずすべてを文字起こしします。
- 発話の検出 — ミーティングの外(と、上がオフのときのミーティング中)に使います。
| 選択肢 | 動き |
|---|---|
| 常に文字起こし | すべてを文字起こしします。電力をいちばん多く使います |
| 高い(小さな声も) | 小さな声も文字起こしします |
| 標準(既定) | 無音と判断した部分を文字起こしせず、電力を節約します。小さな声も飛ばされることがあります。1.8.3 より前と同じです |
| 省電力 | いちばん多く飛ばし、電力をいちばん使いません |
入力レベルの点
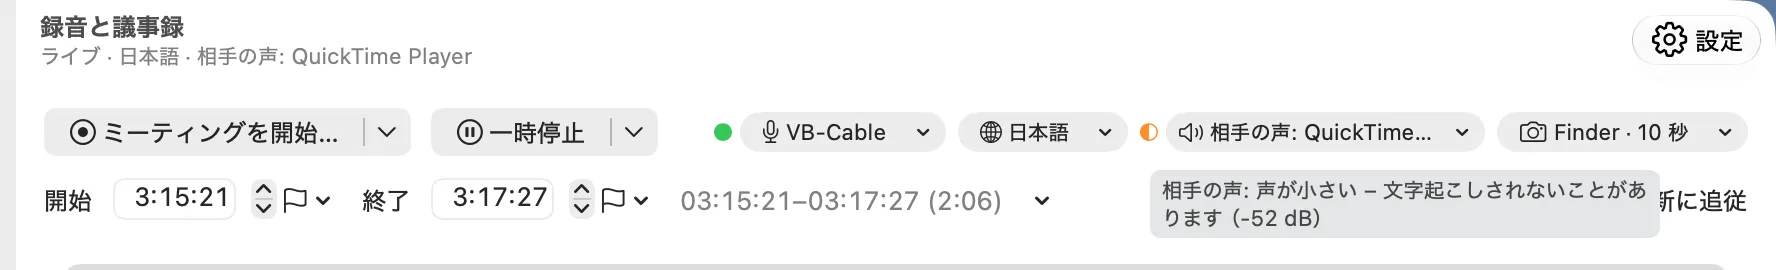
「録音と議事録」のウインドウのライブのペインで、マイクのチップと相手の声のチップの左に小さな点が出て、そのトラックの今の様子を示します。ポインタを重ねると詳しい説明(音量の dB つき)が出ます。
| 点 | 意味 |
|---|---|
| 緑の丸(塗り) | 文字起こし中 |
| 橙の半分の丸 | 声が小さい: 文字起こしされないことがあります(「高い(小さな声も)」か「常に文字起こし」を試してください) |
| 灰色の丸(枠だけ) | 音なし |
| 灰色の斜線の丸 | 文字起こしはオフです(ミーティングの一時停止中も) |
「なし」にしたトラックには点を出しません。メニューにも出ません。
文字起こしが止まったとき
音が届いているのにしばらく行が出ないときや、音声認識が音声を読まなくなったときは、Minutes Ago が自動で文字起こしを作り直します。まずそのトラック、次に両方のトラックです。そのあいだも録音は続きます。言葉の無い音楽や環境音で行が出ないだけなら、止まったとはみなしません。
- それでも戻らないときは、メニューに橙色の行「文字起こしが止まっています(10:03 から)」と「文字起こしを再開」が出ます。
- 録音中のメニューには、いつも 「文字起こしを再起動」 があります。両方のトラックのライブ文字起こしを今すぐ作り直し、録音は途切れずに続きます。出るはずの行が出ないときに使ってください。
- 文字起こしをそもそも始められないときは、間隔をあけながら(15 秒から最大 5 分おきまで)自動で再試行します。
文字起こしのモデル
| モデル | 言語 | ダウンロード | 備考 |
|---|---|---|---|
| Apple(この Mac) | この Mac の音声認識の言語 | macOS が管理します(言語ごとのモデルは、その言語を初めて使うときにダウンロードします) | 録音中に使うモデル。文字起こしのやり直しでも選べます |
| Whisper large-v3-turbo | Whisper が対応している言語(話す言語を選びます) | 1.64 GB | GPU で動き、数秒で使えるようになります。「詳細」で Neural Engine に切り替えることもできます(モデルのダウンロード) |
| Whisper large-v3-turbo (Compact) | 同上 | 645.7 MB | 同じモデルを圧縮したもの |
| Parakeet TDT (Japanese) | 日本語だけ | 619.1 MB | 速いモデル。最近の Mac なら 1 時間の音声を 30 秒ほどで文字起こしします。初回に最適化します(2 分ほど) |
| Cohere Transcribe (Beta) | 14 言語: 英語、フランス語、ドイツ語、スペイン語、イタリア語、ポルトガル語、オランダ語、ポーランド語、ギリシャ語、アラビア語、日本語、中国語、韓国語、ベトナム語 | 2.19 GB(発話の検出のモデル Silero VAD、約 1 MB を含む) | 句読点もつきます。GPU で動き、読み込みに 2 分ほど、その後トラックごとに 1 時間の音声で 6 分ほどかかります。モデル自身は時刻を出さないため、1 行は間で区切ったひと続きの発話になります。中国語は北京語なので、中国語(香港)(Apple の音声認識では広東語)には使えません |
- どのモデルもこの Mac の中で動き、音声も文字起こしも送りません。モデルのダウンロードでも音声や文字起こしは送りませんが、通信の性質上、IP アドレスなどは Hugging Face に届きます(データとプライバシー)。
- モデルは、対応する言語だけを文字起こしできます。ほかの話す言語では灰色になり、「この言語では使えません」と出ます(例: 「Parakeet TDT (Japanese) — この言語では使えません」)。
- 言語は、選んだ話す言語で文字起こしします。モデルが自分で言語を判定することはありません。
- Cohere Transcribe は、使った後 10 分のあいだ読み込んだままにするので、その間に続けて文字起こしするときは読み込みを待ちません。それを過ぎたときやアプリを起動し直したときは、また読み込みます(「モデルを読み込み中…(2 分ほど)」)。
- 上の時間は開発機(Apple M6、16 GB)での計測です。Mac や、同時に動いているものによって変わります。実際の会議での精度は、どのモデルも測っていません(精度について)。
モデルのダウンロード
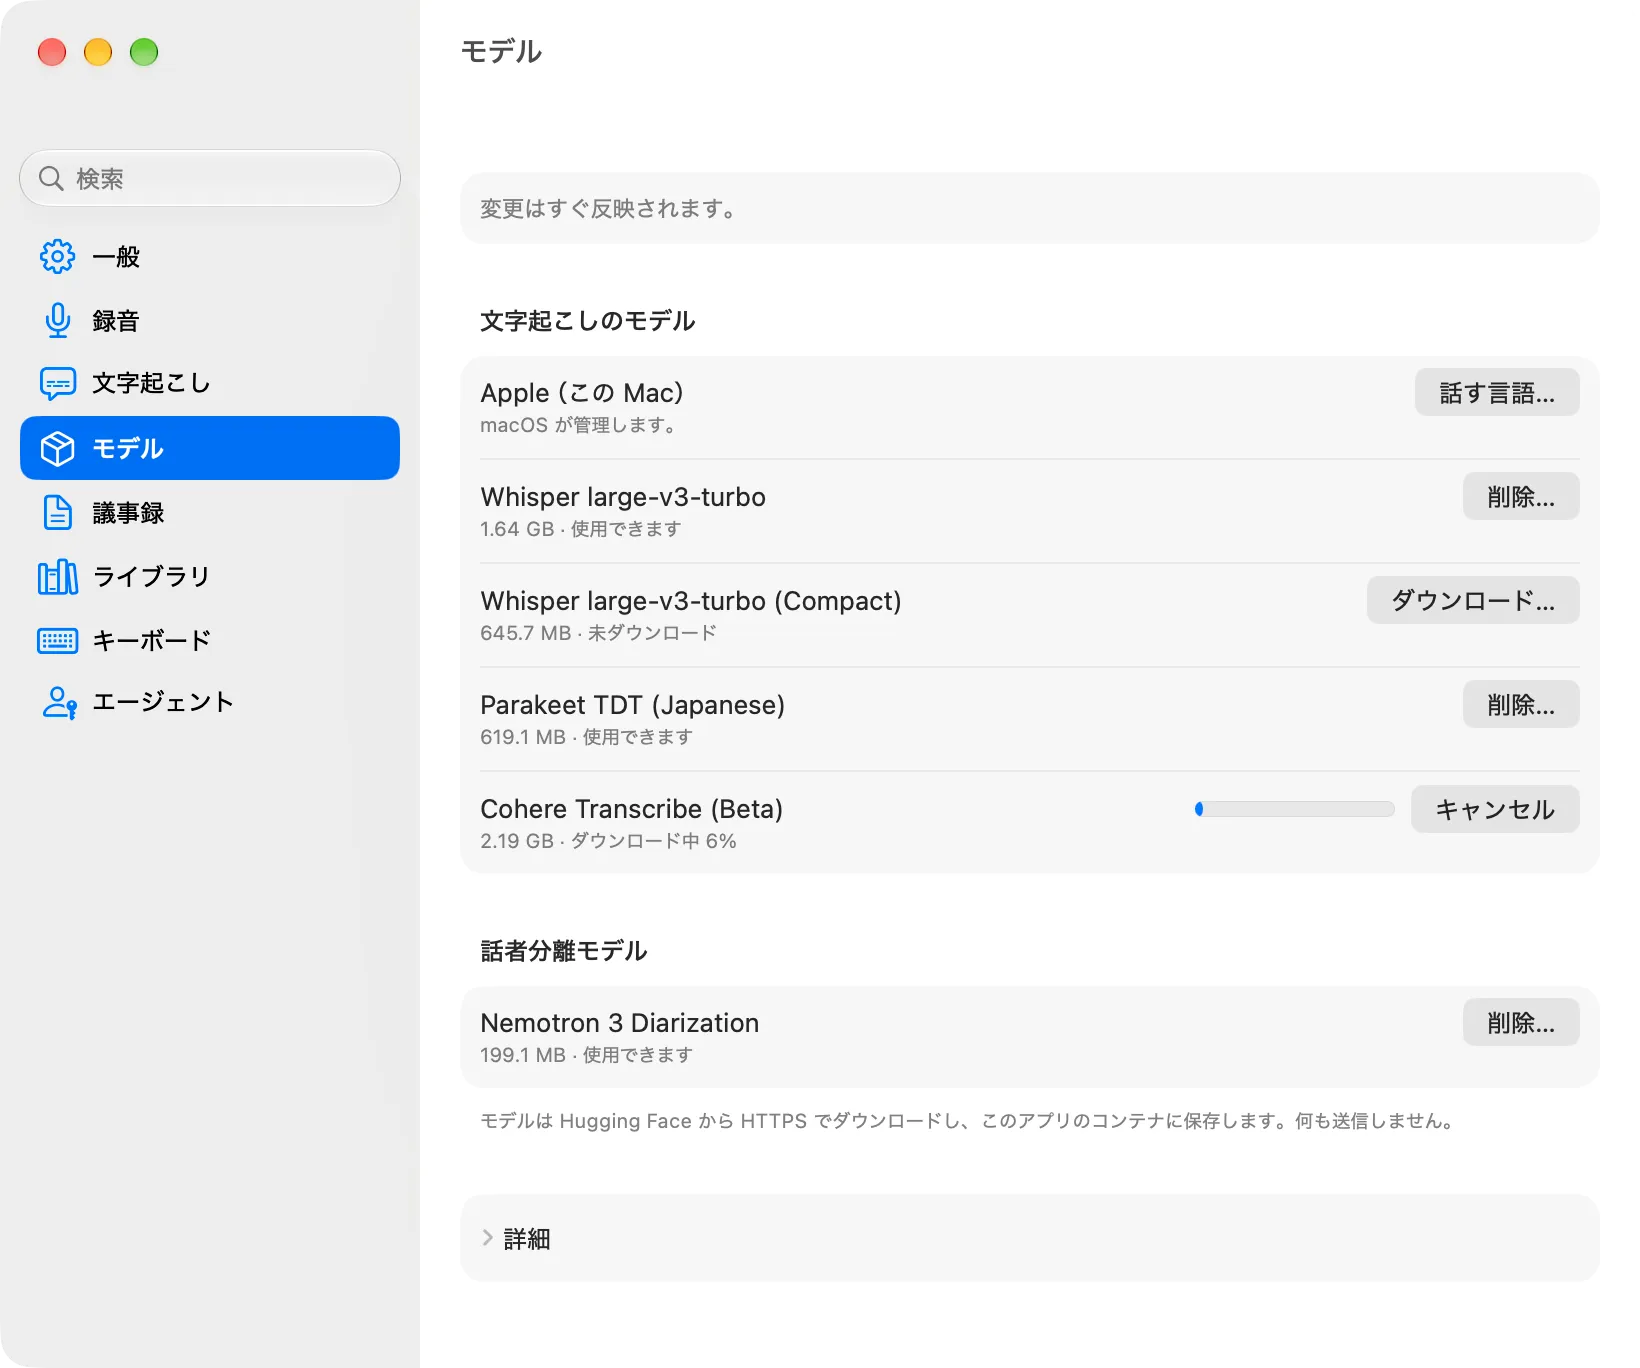
「設定 › モデル」に、モデルがサイズと状態つきで並び、ここでダウンロードと削除をします。モデルは Hugging Face から HTTPS で、このペインからだけダウンロードし、アプリのコンテナに保存します。何も送信しません。
- 文字起こしのモデル — 先頭は「Apple(この Mac)」(「macOS が管理します。」と「話す言語…」。Apple の言語モデルは macOS がダウンロードします)。続けて Whisper large-v3-turbo、Whisper large-v3-turbo (Compact)、Parakeet TDT (Japanese)、Cohere Transcribe (Beta)。
- 話者分離モデル — Nemotron 3 Diarization(199.1 MB)。話者を分離で使います。初めての「話者を分離」で自動でダウンロードするのは今までどおりで、ここでは前もってダウンロードしたり削除したりできます。
各行に、サイズと次のどれかの状態が出ます。
| 状態 | 意味 |
|---|---|
| 未ダウンロード | 「ダウンロード…」が出ます |
| 途中までダウンロード済み(サイズ) | ダウンロードをキャンセルしたか、アプリが終了しました。「ダウンロード…」で続きから落とし、「削除…」でそれまでの分を消します |
| ダウンロード中 n% | 「キャンセル」で止められます(文字起こしのモデル) |
| この Mac 向けに最適化中… | ダウンロードの後、この Mac 向けに一度だけ準備します。Whisper は GPU では数秒です(Neural Engine では「この Mac 向けに最適化中…(Neural Engine では 10 分以上かかることがあります)」)。Parakeet TDT (Japanese) は「この Mac 向けに最適化中…(初回のみ、最大 15 分ほど)」と出て 2 分ほど、Cohere Transcribe は「この Mac 向けに最適化中…(2 分ほど)」で、GPU での最初の読み込みです |
| ダウンロード済み(初回の使用時に最適化) | ダウンロードは済んだが、まだ最適化していない(最適化が途中で止まった場合など)。最初の文字起こしで最適化します |
| 使用できます | 使えます |
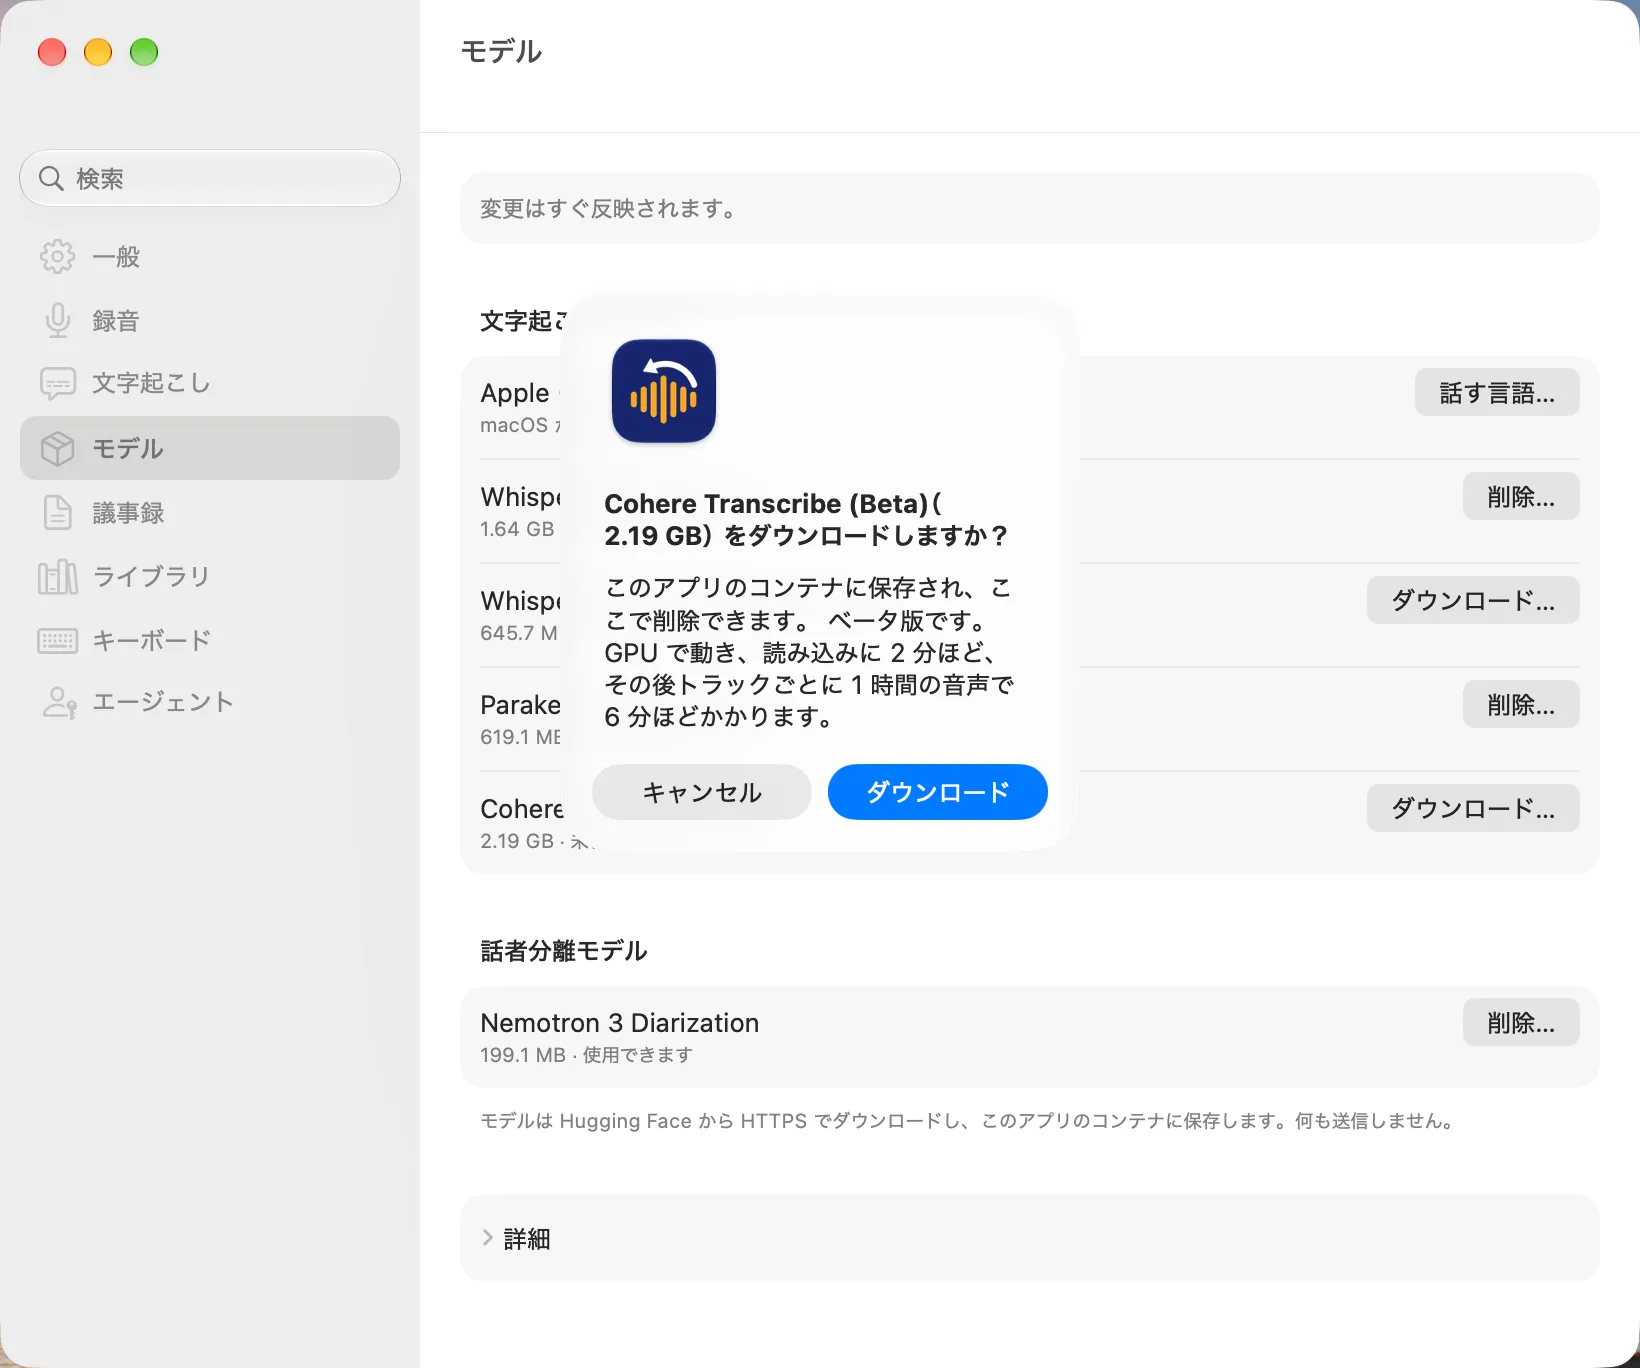
- 「ダウンロード…」 は、サイズを示して確認します: 「Whisper large-v3-turbo(1.64 GB)をダウンロードしますか?」「このアプリのコンテナに保存され、ここで削除できます。」。Cohere Transcribe では「ベータ版です。GPU で動き、読み込みに 2 分ほど、その後トラックごとに 1 時間の音声で 6 分ほどかかります。」が続きます。
- 「削除…」 は「「…」を削除しますか?」「ここでもう一度ダウンロードできます。」と確認します。Cohere Transcribe を削除しても、発話の検出のモデル(約 1 MB)は残ります。
- 文字起こしの実行中は、文字起こしのモデルの「ダウンロード…」と「削除…」が灰色になります(「別の文字起こしが終わるまで待ってください。」)。話者の分離中は、話者分離モデルの分が灰色になります(「話者の分離が終わるまで待ってください。」)。
- ダウンロードに失敗すると、行に理由が出ます: 「この Mac の空き容量が足りません。」「モデルをダウンロードできませんでした。ネットワークを確かめて、もう一度お試しください。」「Hugging Face が混み合っています。しばらくしてからもう一度お試しください。」。最適化に失敗したときは「モデルを最適化できませんでした。もう一度ダウンロードするか、削除してからやり直してください。」。
- 最適化は一度だけです。アップデートの後に、もう一度必要になることがあります。
「詳細」›「Whisper の実行先」: GPU(既定)か Neural Engine。行にポインタを置くと「GPU は数秒で使えるようになります。Neural Engine はメモリの使用量が少なめです。」と出ます。下の注記は「Neural Engine: 最初の最適化に 10 分以上と、75 GB を超える空きディスクが要ることがあります。」。切り替えると、ダウンロード済みの Whisper のモデルをすぐにその実行先向けに最適化し直します(行が「この Mac 向けに最適化中…」になります)。空きディスクが足りない Mac では GPU のままにしてください。
別のモデルで文字起こしし直す
入口は 3 つあります。どれも同じ「モデル」のメニューを使い、最後に選んだモデルを覚えています。
| 場所 | 操作 | 置き換わるもの |
|---|---|---|
| ライブのペインの範囲 | 範囲を選んで ⋯ ›「文字起こしをやり直す…」 | 範囲の行(選んだトラックの分) |
| 保存した録音 | ⋯ ›「文字起こしをやり直す…」、または見出しの「〜で文字起こし」のメニューの「オプションを指定して文字起こしをやり直す…」(モデルごとの文字起こし) | 録音の、そのモデルの文字起こし |
| 音声・動画ファイル(Minutes Ago Pro) | 取り込みのシートの「モデル」 | —(ファイルから作った録音を、まずそのモデルで文字起こしします。その後は保存した録音なので、上の行と同じです) |
シート
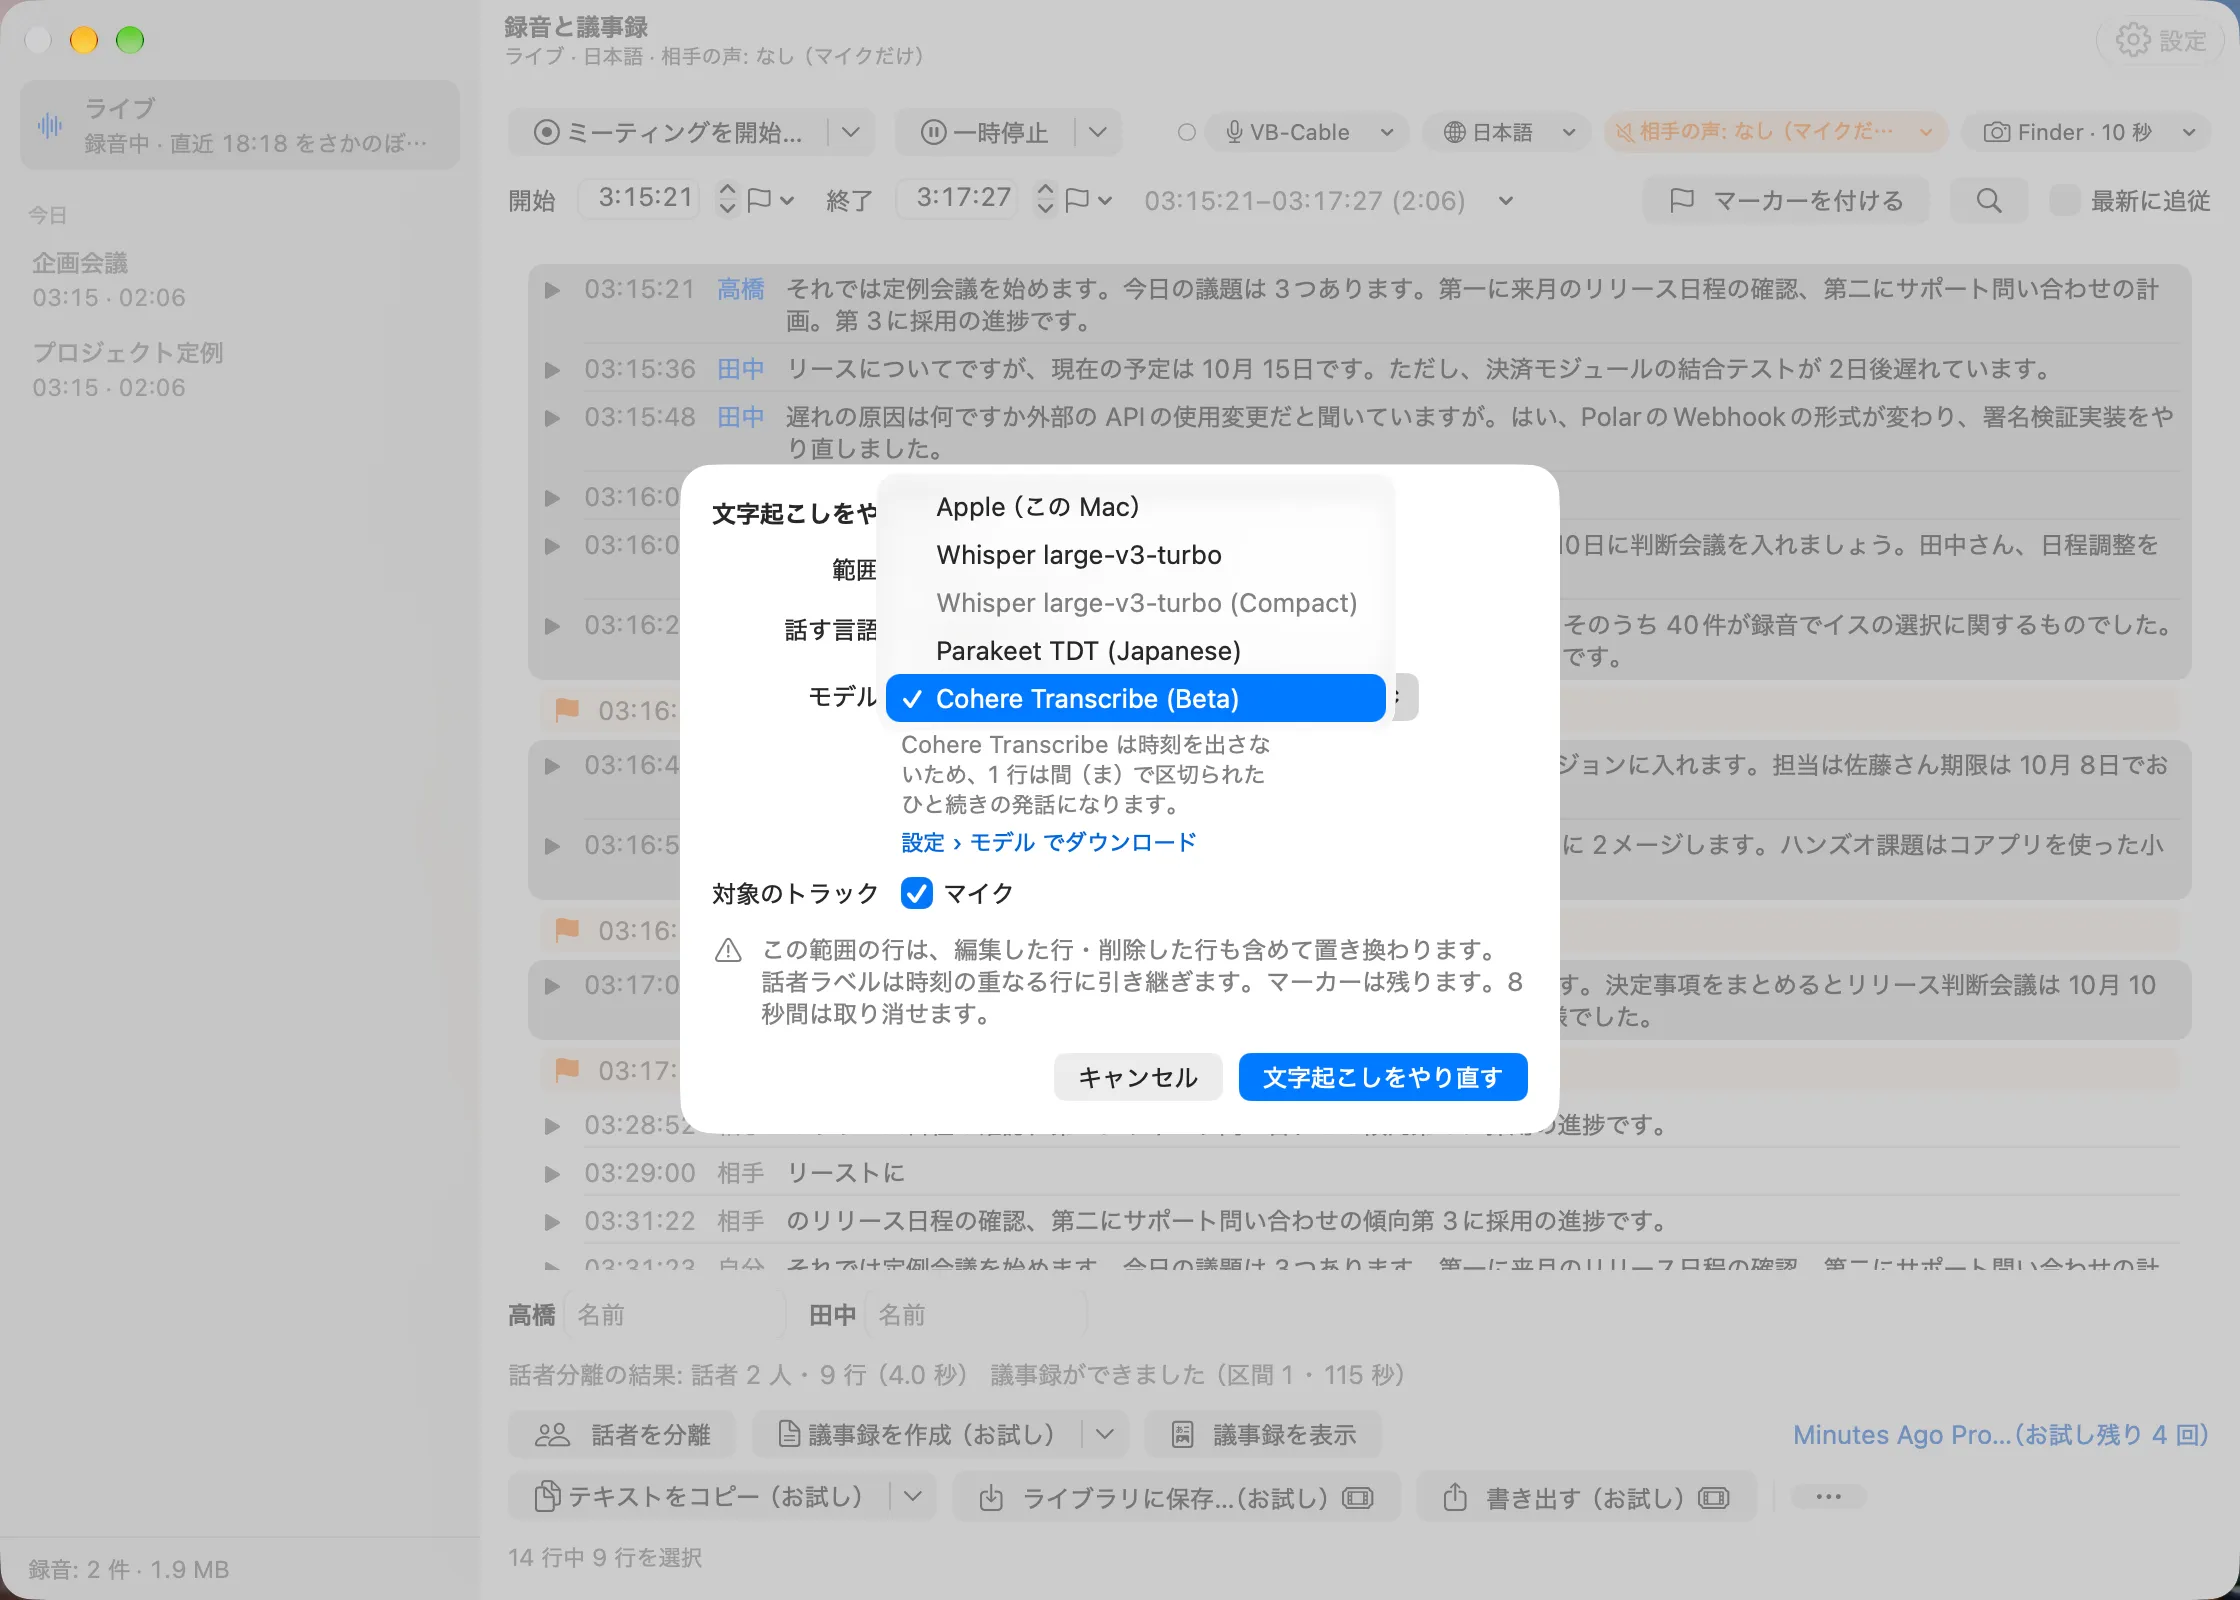
「文字起こしをやり直す…」でシートが開きます。
-
範囲(ライブのペインだけ) — 例:
12:03:10–12:48:02 · 45 分。 -
話す言語 — 最初は、いまライブで使っている言語(ライブ)か、録音の言語です。
-
モデル — 「Apple(この Mac)」、続けてほかのモデル。いま使えないモデルは灰色になり、メニューの下に理由が出ます。
- ダウンロードしていない — 「設定 › モデル でダウンロード」(ペインへのリンク)
- この言語に対応していない — 「この言語では使えません」
- 「設定 › モデル」で最適化中 — 「設定 › モデル で最適化中」
選んだモデルがまだ最適化されていなければ、Parakeet TDT (Japanese) では「初回の使用時にモデルを最適化します(最大 15 分ほど)。」、Neural Engine で動かす Whisper では「初回の使用時にモデルを Neural Engine 向けに最適化します(10 分以上)。」と出ます(GPU で動かす Whisper は数秒で使えるようになるので出ません)。Cohere Transcribe では「Cohere Transcribe は時刻を出さないため、1 行は間(ま)で区切られたひと続きの発話になります。」と出ます。選んだモデルが対応しない言語に変えると、「Apple(この Mac)」に戻ります。
-
対象のトラック — 「マイク」と「相手の声」。両方あれば両方にチェックが入っています。
-
下に、何が起きるかの注意。「キャンセル」「文字起こしをやり直す」。
実行中は、状態行に進み具合が出ます(範囲では「文字起こし中 · 40%」、録音では「Whisper large-v3-turbo で文字起こし中 · 40%」)。Whisper・Parakeet・Cohere では、先にモデルを読み込みます(「モデルを読み込み中…」。GPU で動かす Whisper は数秒です。Neural Engine で動かす Whisper は「モデルを読み込み中…(Neural Engine では 10 分以上かかることがあります)」、Parakeet TDT は「モデルを読み込み中…(初回のみ、最大 15 分ほど)」、Cohere Transcribe は「モデルを読み込み中…(2 分ほど)」)。録音と録音中の文字起こしは続きます。Mac の音声認識の資源が足りないときだけ、終わるまで録音中の文字起こしを一時停止します。
ライブのペインの範囲
- 範囲の行をアプリのデータの中で置き換えるので、ウインドウ・「テキストをコピー」・書き出し・議事録・エージェントのどれもが新しい行を使います。
- 「この範囲の行は、編集した行・削除した行も含めて置き換わります。話者ラベルは時刻の重なる行に引き継ぎます。マーカーは残ります。8 秒間は取り消せます。」
- 範囲は、トラックごとに最後に確定した行で終わるので、文字起こし中の音声はそのままです。結果に終わりの時刻が出ます(例: 「Whisper large-v3-turbo で文字起こしし直しました · 42 行 · 12:47:50 まで」)。
- そのあいだ「話者を分離」は灰色です(「範囲の文字起こしのやり直しが終わるまで待ってください。」)。「まだ保存していない録音を消去…」で止まり、行は変わりません。
- 録音中の文字起こしは、Apple の音声認識のまま続きます。文字起こしし直すのは選んだ範囲だけです。
保存した録音
「選んだモデルの文字起こしを作り直して表示します。そのモデルの文字起こしがあれば、編集・削除した行も含めて置き換えます。選ばなかったトラックは、そのモデルの行(無ければ今の文字起こしの行)のままなので、2 つが混ざることがあります。話者名は同じ時刻の行に引き継がれます。8 秒間は取り消せます。」。マーカーと議事録は残ります。
取り消し
シートから文字起こしし直した後の 8 秒間は、状態行の「取り消す」で前の行に戻せます(「前の文字起こしに戻しました」)。保存した録音では、前の言語とモデルも戻ります。そのあいだに行を直したり消したりすると、取り消しでは戻りません。
一度に 1 つ
文字起こしは一度に 1 つだけ動きます(範囲、保存した録音、取り込んだ音声ファイルの最初の文字起こし)。1 つが動いているあいだ、ほかと、取り込みのシートの「取り込む」は灰色です(「別の文字起こしが終わるまで待ってください。」)。その範囲や録音の話者分離・議事録の作成中と、範囲では「録音中に文字起こしする」がオフのとき(「文字起こしはオフです」)も、「文字起こしをやり直す…」は灰色です。
モデルごとの文字起こし
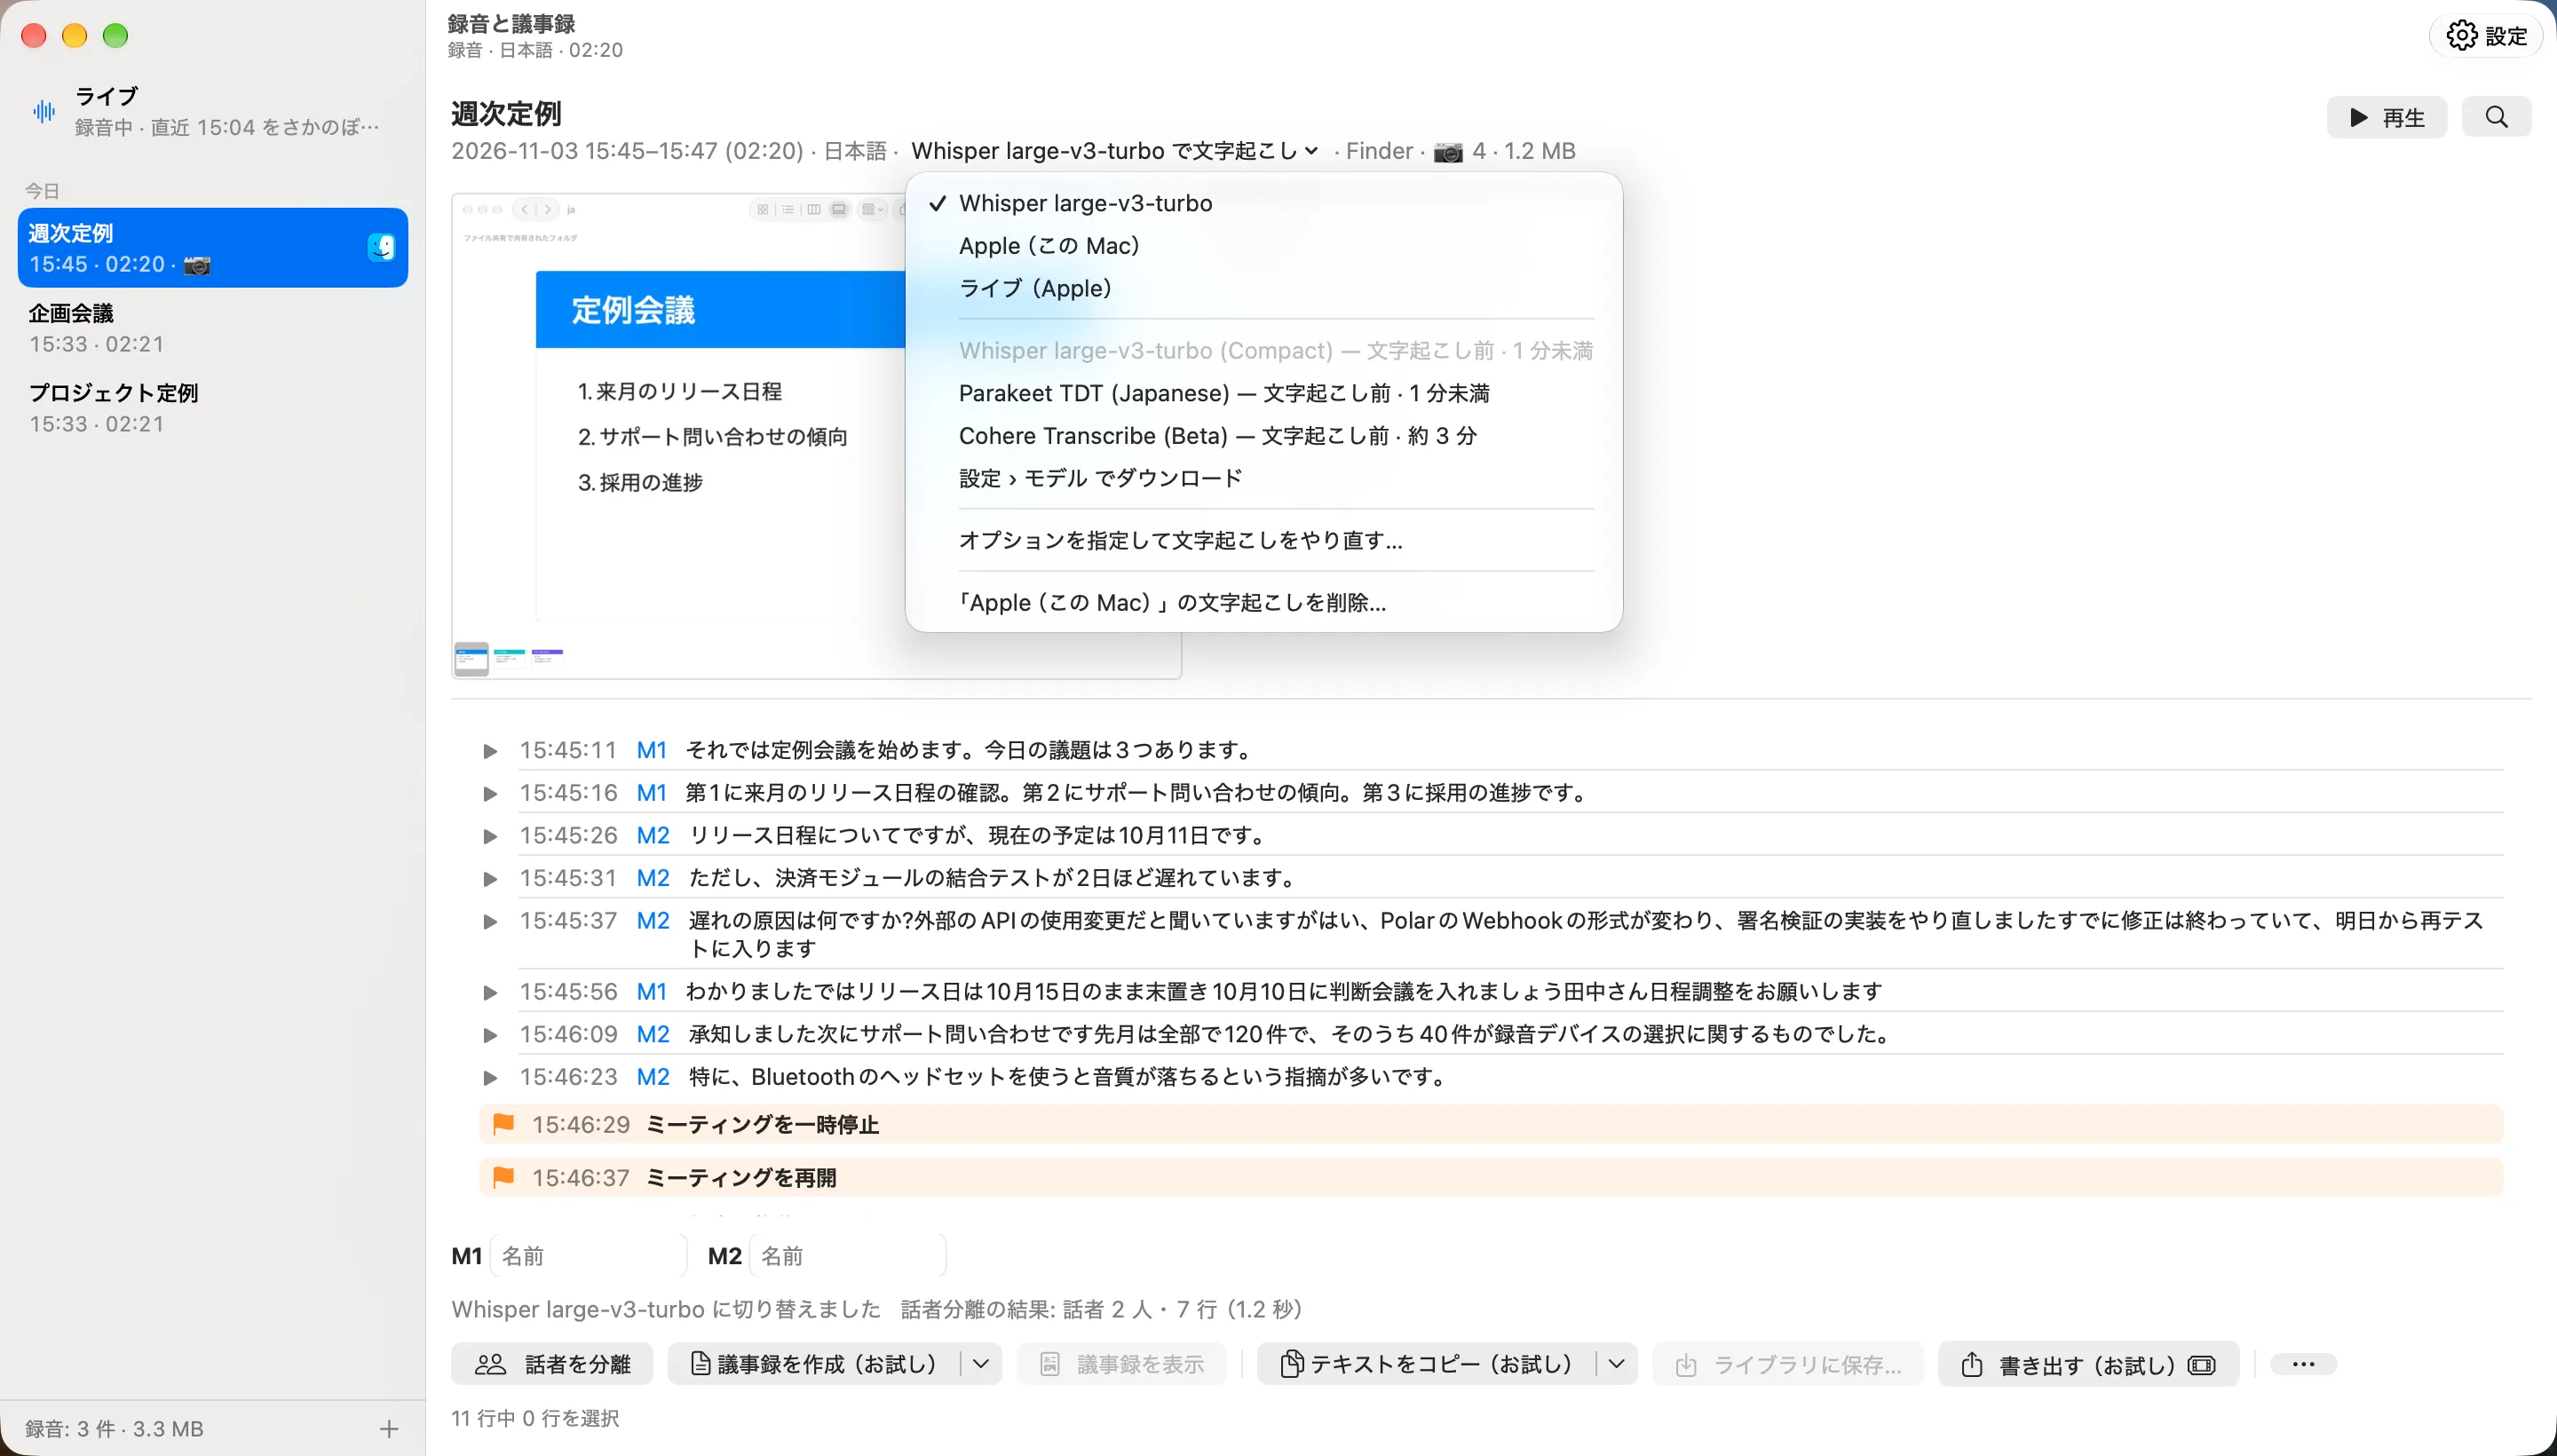
保存した録音は、モデルごとの文字起こしを持てます。録音の見出しに、いま表示している文字起こしが「ライブ(Apple) で文字起こし」のように出ていて、これがメニューになっています。
- ✓ の付いた今の文字起こし、続けて録音が持っているほかの文字起こし。選ぶとそれに切り替わります。「ライブ(Apple)」は録音中に作った文字起こし(録音と一緒に保存したもの)です。手で直したものには「· 編集済み」が付きます。
- まだ文字起こししていないモデル。目安の時間つきで、例えば「Whisper large-v3-turbo — 文字起こし前 · 約 8 分」(1 時間・2 トラックの録音の場合)。まだ最適化していないモデルには、Parakeet TDT では「+ 初回の最適化(最大 15 分)」、Neural Engine で動かす Whisper では「+ 初回の最適化(10 分以上)」が付きます。選ぶと確認なしで、今の文字起こしの言語ですぐに始まり、終わるとそのモデルに切り替わります(「Whisper large-v3-turbo に切り替えました」)。この操作には取り消しはありません。同じメニューで切り替えて戻します。ダウンロードしていないモデル、録音の言語に対応しないモデル(「この言語では使えません」)、最適化中のモデル(「設定 › モデル で最適化中」)は灰色で、「設定 › モデル でダウンロード」でペインが開きます。
- オプションを指定して文字起こしをやり直す… — シートで言語とトラックも選びます。
- 「…」の文字起こしを削除… — 持っている文字起こしを削除します(今の文字起こしと、作り直せない「ライブ(Apple)」は除く)。「編集した行も含めて、この文字起こしの行を削除します。音声は残るので、このモデルでもう一度文字起こしできます。」と確認します。
モデルが文字起こししているあいだも、今の文字起こしを読んだり直したりできます。終わったときに行を編集中なら、「編集が終わったら Whisper large-v3-turbo に切り替えます…」と出て待ちます。
文字起こし同士の関係:
- 直した行・削除した行は、そのモデルの文字起こしにだけ残ります。
- 話者の分離と話者の名前は、すべての文字起こしに付きます。
- 「テキストをコピー」・書き出し・議事録・エージェントは、今の文字起こしを使います。
- 別のモデルの文字起こしから作った議事録には、シートにそのことが出ます(例: 「ライブ(Apple) の文字起こしから作成」)。
- どの文字起こしも、この Mac の録音のフォルダの中に置きます。録音を削除すると、すべて消えます。
無料で使えるもの
- どのモデルでの文字起こしのやり直し(範囲・保存した録音)も、モデルごとの文字起こしの作成・切り替え・削除も、モデルのダウンロードと削除も無料です。お試しを使わず、「(お試し)」「(Pro)」の印も付きません。
- その後の取り出しは、今までどおりに数えます(何が 1 回に数えられますか)。ライブのペインでは、30 分より前・話者名つき・この Mac の外のプロバイダのコピー・書き出し・議事録・エージェントの要求は、Pro を入手するまでお試しを使います。保存した録音からは無料です(保存のときに数えています)。ただし保存した後に付けた話者名(1 回だけ)と、この Mac の外のプロバイダでの議事録は除きます。話者名があるかどうかは、今の文字起こしで決まります。
- 音声ファイルの取り込みは、どのモデルでも Minutes Ago Pro(直販版はライセンス)の機能で、お試しの対象外です(音声ファイルの取り込み)。取り込んだ後は保存した録音なので、別のモデルでの文字起こしのやり直しは上のとおり無料です。